
PDF in Text umwandeln
Mit diesem kostenlosen Tool können Sie PDF in Text umwandeln. Es kopiert den im PDF gespeicherten Text in eine einfache UTF-8-Textdatei, damit Sie pdf text kopieren können. Es liest die Textebene der Datei, nicht Bilder von Text, daher liefert ein Scan keinen Text. Nutzen Sie es, wenn Sie Wörter aus einem PDF einfügen, durchsuchen oder bearbeiten möchten.
- Das Tool kopiert nur die Textebene. Ein Scan oder ein Bild von Text ergibt kein Ergebnis. Nutzen Sie für solche Dateien das Tool „Bild in Text“.
- Verschlüsselte PDFs werden abgelehnt. Es wird kein Passwort akzeptiert.
- Die Ergebnisse hängen von der Datei ab. Prüfen Sie den Text, bevor Sie ihn verwenden.
Ziehen Sie eine Datei hierher oder wählen Sie eine aus. Bis zu 10 MB pro Datei ohne Konto.
Geben Sie Zahlen oder Bereiche wie 1-3,5 ein; z ist die letzte Seite. Der Text erscheint in Seitenreihenfolge.
Bestätigen Sie die Sicherheitsprüfung, um die Schaltfläche zu aktivieren.
Ergebnis
Ihr Text erscheint hier.
Ohne Konto: 20 Aufträge pro Tag, bis zu 10 MB pro Datei, 100 Seiten. Angemeldet: bis zu 50 MB pro Datei, 500 Seiten.
Aufbewahrung: Ergebnisse der Web-Tools werden nach 10 Minuten gelöscht. API-Ergebnisse werden im kostenlosen Tarif 1 Tag aufbewahrt und bei Starter und Pro 7 Tage (bei Business und Scale 30 Tage). Ein Protokoll jedes Auftrags (Typ, Zeit, Status und Credits, nicht das, was Sie eingereicht haben) wird 30 Tage ohne Konto aufbewahrt oder, wenn Sie angemeldet sind, solange Ihr Konto besteht.
Kein Konto erforderlich
20 PDF-Aufträge pro Tag und Besucher.
Seiten werden nicht neu gezeichnet
Die Seiten werden ohne erneute Kodierung kopiert oder gedreht, sodass Text und Bilder ihre Qualität behalten.
Automatisch gelöscht
Ergebnisse des Web-Tools werden nach 10 Minuten entfernt.
Datenschutz: Was Sie einreichen, wird nur für diese Datei verwendet. Es wird gelöscht, sobald der Auftrag endet, auch aus dem Auftragsprotokoll, und das Ergebnis nach 10 Minuten. Siehe die Datenschutzerklärung.
So machen Sie es in Ihrem Code
Derselbe Auftrag als API-Anfragen: Laden Sie jede PDF-Datei hoch, starten Sie den Auftrag mit den Upload-IDs und fragen Sie ihn danach ab. Sie benötigen einen API-Schlüssel; ein kostenloses Konto kann einen erstellen.
curl -X POST "https://api.aiipworld.com/v1/uploads" \
  -H "Authorization: Bearer $AIIPWORLD_API_KEY" \
  -H "Content-Type: application/pdf" \
  --data-binary @input.pdf   # returns {"upload_id": "UPLOAD_ID_1", ...}

curl -X POST "https://api.aiipworld.com/v1/pdf-jobs" \
  -H "Authorization: Bearer $AIIPWORLD_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"op":"pdf_to_text","params":{},"files":["UPLOAD_ID_1"]}'
# returns {"job_id": "...", "status": "queued"}; then poll:
curl https://api.aiipworld.com/v1/jobs/JOB_ID -H "Authorization: Bearer $AIIPWORLD_API_KEY"
Stapel
Das Web-Tool bearbeitet jeweils eine PDF-Datei. Verwenden Sie die API für viele Dateien; jeder Auftrag nimmt eine PDF-Datei entgegen.
Aufbewahrung
Ergebnisse von Web-Tools werden 10 Minuten gespeichert; Ergebnisse der kostenlosen API 1 Tag; Ergebnisse von Starter und Pro 7 Tage; Business und Scale 30 Tage.
In einem Satz
Ein kostenloses Online-Tool, das die Textebene eines PDFs mit Poppler pdftotext in eine einfache UTF-8-Textdatei kopiert, für alle Seiten oder einen Bereich. Ein Scan ohne Textebene ergibt ein leeres Ergebnis und kostet keine Credits.
Die wichtigsten Fakten
- Eingabe: ein PDF mit bis zu 10 MB ohne Konto (50 MB angemeldet), bis zu 100 Seiten (500 angemeldet); verschlüsselte PDFs werden abgelehnt.
- Einstellungen: die zu lesenden Seiten (Zahlen und Bereiche wie 1-3,5), Layout so weit wie möglich beibehalten (nach bestem Bemühen, Spalten und Tabellen können trotzdem ungleichmäßig aussehen) und vor jeder Seite eine Zeile --- Page N ---; das Ergebnis ist text.txt und wird zusätzlich in einem Feld mit Schaltfläche „Kopieren“ angezeigt.
- Es liest nur die gespeicherte Textebene und ist keine OCR: Ein Scan oder ein Bild von Text ergibt ein leeres Ergebnis, der Hinweis im Ergebnisbereich verweist auf das Tool „Bild in Text“, und es werden keine Credits verbraucht.
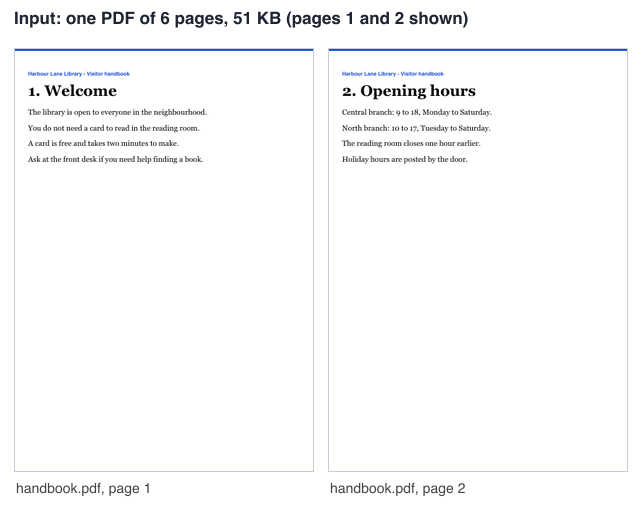
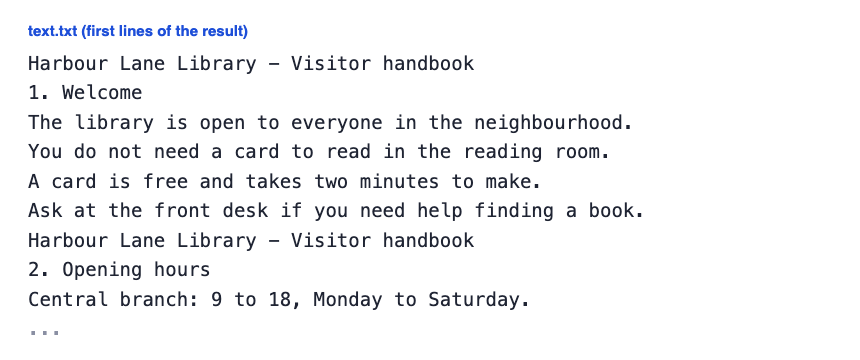
- In unserem Test ergab ein erzeugtes Text-PDF mit 6 Seiten und 51 KB eine Textdatei mit 1,4 KB und 1.138 Zeichen ohne Leerzeichen; die Ergebnisse hängen von der Datei ab.
- API: Laden Sie das PDF per POST an https://api.aiipworld.com/v1/uploads hoch, senden Sie dann einen POST an https://api.aiipworld.com/v1/pdf-jobs mit op pdf_to_text und der Upload-ID und fragen Sie GET /v1/jobs/:id ab.
- Kostenlos ohne Konto: 20 PDF-Aufträge pro Tag und Besucher, ohne Wasserzeichen. Angemeldet kostet jeder Auftrag 1 Credit, ein PDF ohne Text kostet nichts (100 kostenlose Credits jeden Monat).
- Dateien werden automatisch gelöscht: 10 Minuten nach der Umwandlung ohne Konto, 1 Tag mit einem kostenlosen Konto.
Quellen
Zuletzt geprüft:
So funktioniert es
- Laden Sie Ihr PDF in das Tool hoch. Das Tool prüft, ob die Datei ein PDF ist, bevor es startet.
- Geben Sie im Feld „Seiten“ die gewünschten Seiten ein, zum Beispiel 1-3,5. Lassen Sie das Feld leer, um alle Seiten umzuwandeln.
- Aktivieren Sie „Layout so weit wie möglich beibehalten“ oder „Vor jeder Seite eine Zeile --- Page N --- einfügen“, wenn Sie eine der Optionen möchten.
- Klicken Sie auf die Schaltfläche und warten Sie, bis das Ergebnisfeld den Text zeigt.
- Kopieren Sie den Text aus dem Feld mit „Kopieren“ oder laden Sie ihn als text.txt herunter.
Beispielergebnis
Input: one PDF of 6 pages, 51 KB (pages 1 and 2 shown)
Output: text.txt, 1.4 KB
PDF in Text umwandeln: so funktioniert es
Laden Sie das PDF hoch und starten Sie den Auftrag. Das Tool kopiert den Text, der in der Datei gespeichert ist, in eine einfache UTF-8-Textdatei. Der Text erscheint in einem Feld im Ergebnisfeld, wo Sie ihn kopieren oder als text.txt herunterladen können.
Die Umwandlung arbeitet mit dem Text, den das PDF bereits enthält. Bilder von Text werden nicht gelesen. So können Sie ein PDF in Text umwandeln, wenn Sie die Wörter aus einem Bericht, einem Formular oder einem als PDF gespeicherten Artikel herauslösen möchten.
Seiten auswählen
Sie können alle Seiten oder nur einige davon umwandeln. Geben Sie im Feld „Seiten“ Zahlen und Bereiche ein, zum Beispiel 1-3,5. Der Buchstabe z steht für die letzte Seite, also wandelt 4-z die Seite 4 bis zum Ende um.
Der Text erscheint in der Reihenfolge der Seiten, auch wenn Sie die Seiten in anderer Reihenfolge angeben. Seitenzahlen beginnen bei 1, die Null ist nicht gültig. Geben Sie eine Zahl hinter der letzten Seite ein, schlägt der Auftrag fehl und zeigt an, wie viele Seiten das Dokument hat. Ihre Credits werden zurückgegeben.
Layout so weit wie möglich beibehalten
Die Option „Layout so weit wie möglich beibehalten“ richtet den Text mit Leerzeichen so aus, wie ihn die Seite zeigt. Das ist eine Einstellung nach bestem Bemühen: Spalten und Tabellen können trotzdem ungleichmäßig aussehen.
In unserem Test mit einem erzeugten einspaltigen PDF mit 6 Seiten und 51 KB hat die Option wenig verändert: Die Textdatei war mit und ohne sie 1,4 KB groß. Wir haben keine Dokumente mit mehreren Spalten oder vielen Tabellen getestet, prüfen Sie das Ergebnis daher.
Seitenmarkierungen und die Textdatei
Die Option „Vor jeder Seite eine Zeile --- Page N --- einfügen“ setzt vor den Text jeder Seite eine Markierungszeile. Wenn Sie zum Beispiel die Seiten 2-3 umwandeln, beginnt die Datei mit der Zeile --- Page 2 ---. So finden Sie leichter, wo jede Seite beginnt.
Die Ausgabe ist immer eine einfache Textdatei in UTF-8, das Ergebnis ist also eine PDF-Text-Datei, die Sie in jedem Editor öffnen können. Der Download-Name ist text.txt. Markierungen werden nur hinzugefügt, wenn Sie die Option einschalten.
PDFs ohne Textebene (Scans)
Manche PDFs haben keine Textebene. Dazu gehören Scans, Fotos von Seiten und PDFs, die nur aus Bildern bestehen. Oft wird gefragt, wie man bei solchen Dateien Text aus PDF extrahieren kann: Dieses Tool kann das nicht, das Tool „Bild zu Text“ schon. Der Auftrag gelingt trotzdem, das Ergebnis ist aber leer. Das Ergebnisfeld zeigt „In dieser PDF wurde kein Text gefunden“ und verweist auf das Tool „Bild zu Text“, das Text aus Bildern liest.
Hat nur ein Teil der Seiten keine Textebene, nennt das Panel diese Seitenzahlen. Es weist außerdem darauf hin, dass das Tool „Bild zu Text“ sie lesen kann. Der Text der übrigen Seiten wird trotzdem geliefert. In unserem Test ergab ein Bild einer Seite, als PDF gespeichert (32 KB), ein leeres Ergebnis, und es wurde kein Credit verbraucht.
Was Sie im Ergebnis Ihrer PDF-Umwandlung prüfen sollten
Prüfen Sie den Text, bevor Sie ihn weiterverwenden. Der Text wird so kopiert, wie er im PDF gespeichert ist, daher hängen die Ergebnisse von der Datei ab. In unserem Test ergab ein erzeugtes PDF mit 6 Seiten und 51 KB eine Textdatei mit 1,4 KB und 1.138 Zeichen ohne Leerzeichen.
Speichert das PDF Buchstaben auf eine Weise, die das Textprogramm nicht zuordnen kann, können einige Buchstaben falsch oder gar nicht erscheinen. Spalten und Tabellen können ungleichmäßig werden. Wir haben keine Dokumente mit mehreren Spalten oder vielen Tabellen getestet, prüfen Sie diese Ergebnisse daher genau.
Grenzen: Größe, Seiten und Credits
Das kostenlose Web-Tool erlaubt 20 Aufträge pro Tag und Besucher. Diese Zahl wird mit Zusammenführen, Teilen, Drehen, Seiten löschen, PDF in Bild und Bild in PDF geteilt. Ohne Konto braucht jede hochgeladene Datei eine eigene Sicherheitsprüfung und zählt zu 40 Uploads pro Tag und Besucher.
Sie können pro Auftrag ein PDF hochladen, bis zu 10 MB ohne Konto oder 50 MB angemeldet. Ohne Konto dürfen PDFs bis zu 100 Seiten haben. Angemeldet liegt die Grenze bei 500 Seiten.
- Eine Umwandlung im angemeldeten Zustand kostet 1 Credit.
- Die Textdatei hat eine Größenbegrenzung. Ein Ergebnis darüber schlägt fehl, und die Credits werden zurückgegeben.
- Ein Auftrag, der die Zeitgrenze überschreitet, schlägt fehl und wird erstattet.
Verschlüsselte und beschädigte Dateien
Verschlüsselte PDFs werden abgelehnt. Dazu gehören Dateien mit Passwortschutz oder Berechtigungseinschränkungen, unabhängig von deren Stärke. Es wird kein Passwort akzeptiert, und das Tool versucht nicht, den Schutz zu öffnen oder zu umgehen. Entfernen Sie den Schutz zuerst in der Originalanwendung, wenn Sie dazu berechtigt sind.
Beschädigte PDFs werden nach Möglichkeit automatisch repariert. Das Ergebnisfeld zeigt dann „Die Datei hatte geringfügige Schäden, die automatisch repariert wurden“. Die Einstellung „Ein leicht beschädigtes PDF automatisch reparieren“ ist standardmäßig aktiviert. Schalten Sie sie aus, wird eine beschädigte Datei abgelehnt. Lässt sich eine Datei nicht reparieren, wird sie abgelehnt.
PDF in Text umwandeln per Code
Dieselbe Umwandlung können Sie über die API nutzen. Senden Sie die Datei zuerst als Rohdaten mit Content-Type application/pdf an https://api.aiipworld.com/v1/uploads. Die Antwort enthält eine upload_id. Jede Anfrage nimmt eine Datei.
Senden Sie danach einen POST an https://api.aiipworld.com/v1/pdf-jobs mit JSON, das op auf pdf_to_text, params und files mit der upload_id enthält. Die params sind layout (true oder false), pages, page_markers (true oder false) und allow_repair. Senden Sie Ihren API-Schlüssel mit einem Header Authorization: Bearer oder einem Header x-api-key.
Fragen Sie danach GET /v1/jobs/:id ab, bis der Auftrag erfolgreich ist, fehlschlägt oder eine Zeitüberschreitung auftritt. Ein erfolgreiches Ergebnis enthält die Textdatei, chars, pages_out und empty. Die download_url zeigt auf eine .txt-Datei und ist ein kurzlebiger signierter Link. Das Ergebnis ist leer, wenn keine Textebene vorhanden ist, und ein Hinweis schlägt die Operation image_to_text (OCR) vor. Fehler sind unter anderem 400 invalid_params, 413 file_too_large, 422 not_a_pdf, 404 upload_not_found, 402 insufficient_credits und 429 zu viele Anfragen. Ein fehlgeschlagener Auftrag kann Fehlercodes wie encrypted_pdf, corrupt_pdf, too_many_pages, page_out_of_range und bad_params zurückgeben.
Die Seite zeigt fertige Beispiele für cURL, Node und Python, passend zu den gewählten Einstellungen. Die allgemeine API finden Sie unter /docs/. Einen Stapel-Endpoint und Webhooks gibt es noch nicht.
Datenschutz: was mit Ihrer Datei geschieht
Ihre Datei wird zur Erstellung des Ergebnisses an unseren Server gesendet. Es wird nichts im Browser verarbeitet. Sie müssen das Recht haben, die hochgeladenen Inhalte zu nutzen, wie in unserer Richtlinie zur zulässigen Nutzung beschrieben.
Die hochgeladene Datei wird nur zur Erstellung des Ergebnisses genutzt. Die Arbeitskopie wird gelöscht, sobald der Auftrag endet, egal ob er gelingt oder fehlschlägt. Von jedem Auftrag wird ein Protokoll geführt, und angemeldete Nutzer können ihre Aufträge im Dashboard einsehen. Das Ergebnis wird im kostenlosen Web-Tool nach 10 Minuten gelöscht, und das Ergebnisfeld zeigt, wie lange es verfügbar bleibt. Download-Links sind kurzlebig, speichern Sie Ihren Text daher, sobald Sie ihn erhalten.
Fragen
Kann ich ein PDF kostenlos in Text umwandeln?
Ja, Sie können das kostenlose Web-Tool ohne Konto nutzen, innerhalb des täglichen Limits von 20 Aufträgen pro Besucher.
Wie kann ich Text aus PDF-Dateien kopieren, ohne ihn zu markieren?
Das Tool kopiert Text aus einer PDF-Datei in einem Schritt in eine TXT-Datei, sodass Sie ihn nicht in einem Viewer markieren müssen. Es kopiert nur gespeicherten Text, bei einem Scan erhalten Sie daher nichts.
Wie kopiere ich den Text nur von bestimmten Seiten?
Geben Sie die Seiten vor dem Start im Feld „Seiten“ ein, zum Beispiel 1-3,5. Lassen Sie das Feld leer, um jede Seite umzuwandeln.
Warum sagt das Tool, dass kein Text gefunden wurde?
Das PDF hat keine Textebene, es ist also wahrscheinlich ein Scan oder eine Sammlung von Bildern. Nutzen Sie das Tool „Bild zu Text“, um Text aus diesen Seiten zu lesen.
Liest das Tool gescannte PDFs?
Nein, das Tool kopiert nur gespeicherten Text und liest keine Bilder von Text. Bei gescannten Seiten verweist das Ergebnisfeld auf das Tool „Bild zu Text“.
Was bewirkt Layout beibehalten?
Es richtet den Text mit Leerzeichen aus, damit er der Seite näherkommt. Das ist eine Einstellung nach bestem Bemühen und hat in unserem Test eines einfachen einspaltigen Dokuments wenig verändert.
Werden Spalten und Tabellen richtig übernommen?
Das ist nicht sicher. Spalten und Tabellen können ungleichmäßig werden, auch wenn die Layout-Option aktiviert ist. Wir haben keine Dokumente mit mehreren Spalten oder vielen Tabellen getestet, prüfen Sie das Ergebnis daher.
Wird der Text als .txt-Datei gespeichert?
Ja. Die Ausgabe ist eine einfache UTF-8-Textdatei, Sie können sie als text.txt herunterladen oder den Text aus dem Feld kopieren.
Kann ich Text aus einem passwortgeschützten PDF extrahieren?
Nein, verschlüsselte PDFs werden abgelehnt, und es wird kein Passwort akzeptiert. Das Tool versucht nicht, den Schutz zu öffnen oder zu umgehen.
Zahle ich für ein PDF ohne Text?
Nein, ein PDF ohne Text kostet nichts, und der reservierte Credit wird erstattet. Eine angemeldete Umwandlung, die Text liefert, kostet 1 Credit.
Kann ich ein PDF in meinem eigenen Code in Text umwandeln?
Ja, die API hat die Operation pdf_to_text, mit der Sie PDF per Code in Text umwandeln. Laden Sie die Datei zuerst hoch, erstellen Sie dann einen Auftrag und fragen Sie ihn ab, bis er fertig ist. Die Seite zeigt fertige Beispiele für cURL, Node und Python, und den allgemeinen API-Leitfaden finden Sie unter /docs/.
Brauchen Sie das in Ihrer App oder in großen Mengen?
Dieses Tool läuft auf derselben Plattform wie die API. Dasselbe Zusammenführen, Teilen oder Drehen ist deshalb aus Ihrem Code zwei HTTP-Anfragen: Laden Sie jede PDF-Datei hoch und starten Sie dann den Auftrag. Ein kostenloses Konto enthält 100 Credits pro Monat.